الخلاصة السريعة
- يتوقع نظام التعرّف على الكلام النص الأرجح لكل مقطع صوتي، إذ لا يوجد نص مخفي داخل التسجيل لاستخراجه.
- ساهم التدريب على كميات ضخمة من الصوت متعدد اللغات في استقرار النماذج، لكن دعم لغة معينة لا يضمن جودتها.
- تمييز المتحدثين والتوقيت وعلامات الترقيم والتصدير كلها أجزاء منفصلة تحيط بمحرك التعرّف، وكل جزء منها يخطئ بمفرده.
- عادةً ما يحسم الميكروفون والغرفة النتيجة أكثر من اختيار النموذج نفسه.
- نبقي الصوت والنص الموقوت والتصحيح البشري في مكان واحد، فهناك تظهر الأخطاء.
1. البرنامج يستقبل إشارة صوتية لا جملة مفهومة
يدخل التسجيل إلى البرنامج كقائمة طويلة من الأرقام، يمثل كل رقم منها ضغط الهواء في لحظة محددة. وقبل اقتراح أي كلمة، يُقطَّع الصوت إلى نوافذ زمنية قصيرة، وتُحلل كل نافذة حسب توزع طاقتها عبر الترددات المختلفة. قوانين الفيزياء هنا ثابتة لا تتغير؛ فصوتان متداخلان، وصدى الغرفة، وصوت مروحة الحاسوب، وضغط الملف، تصل كلها مدمجة في إشارة واحدة.
لهذا السبب يلعب الميكروفون دوراً أكبر مما يتوقعه أغلب المشترين. فالميكروفون القريب من الفم يلتقط الحروف الساكنة بوضوح ويحفظ السكتات القصيرة بين الكلمات. أما الهاتف الموضوع وسط طاولة الاجتماعات فيلتقط صدى الغرفة وأصوات الجميع دفعة واحدة. ولا يوجد نموذج لغوي يستطيع استعادة حرف ساكن ابتلعته الغرفة.
2. المُرمِّز يرسم خريطة للكلام
يأخذ المُرمِّز مقاطع الصوت القصيرة ويحولها إلى متجهات تضم العناصر اللازمة للتوقع، مثل التفاصيل الصوتية، والإيقاع، وتفريق أولي بين الكلام والضجيج والصمت. وقد تغيرت هذه المرحلة كثيراً بفضل التدريب المسبق الواسع. ففي عام 2022، ذكرت ورقة بحثية تدريب نموذج على 680 ألف ساعة من الصوت متعدد اللغات بإشراف ضعيف. وبعدها وسّعت أبحاث أخرى النطاق ليتجاوز مئة لغة، ثم ألف لغة، بالاعتماد على تسجيلات صوتية لم يفرّغها أحد من قبل.123
ضخامة البيانات تمنح النموذج خبرة أوسع، لكنها لا تعني المساواة بين اللغات. فالنموذج الذي مرّت عليه ميكروفونات ولهجات ومواضيع متنوعة لن يتفاجأ كثيراً بتسجيلك. لكن قائمة اللغات المدعومة لا تخبرك كيف سيتعامل النظام مع مكالمة مبيعات بالعبرية، أو مقابلة باللهجة الفلسطينية، أو جملة تبدأ بلغة وتنتهي بأخرى.
3. فك الترميز: منافسة بين الجمل المحتملة
لا ينتقي محرك التعرّف الكلمات واحدة تلو الأخرى. بل يقيّم سلاسل كاملة من الكلمات ويقارنها بالصوت وبما تعلّمه عن تركيب الجمل. لهذا يفضّل النظام جملة مترابطة المعنى على رصّ كلمات متشابهة في الصوت، ولهذا أيضاً قد يعطيك جملة فصيحة وسليمة لم ينطق بها أحد عندما يكون الصوت غير واضح.
تظهر هذه المشكلة بوضوح في الأسماء والأرقام وعند التنقل بين اللغات. وتشير الأبحاث التي تدرس التبديل اللغوي أثناء الكلام دائماً إلى النقص نفسه: هناك وفرة في التسجيلات الصوتية لكل لغة على حدة، وندرة شديدة في التسجيلات التي يغيّر فيها المتحدث لغته وسط الجملة. وتزيد العبرية والعربية الأمر تعقيداً بسبب غياب التوحيد الإملائي وقلة التسجيلات المتاحة للكلام العفوي. ورغم أن قواعد البيانات البحثية الحديثة توفر المزيد من هذه المواد، فإنها لم تسد الفجوة بعد.456
4. النص النهائي حصيلة مراحل متعددة وليس خطوة واحدة
مهمة محرك التعرّف هي إنتاج كلمات وأوقات زمنية. أما فصل المتحدثين فيجيب عن سؤال مختلف تماماً: من تحدث ومتى؟ وتأتي مرحلة المحاذاة لتربط كل كلمة بوقتها الدقيق على الساعة، بينما تتولى علامات الترقيم وتقسيم الفقرات مهمة جعل النص قابلاً للقراءة. بعد ذلك تأتي عمليات الحفظ، وإعادة المحاولة، والتحرير، والبحث، والتصدير. كل خطوة من هذه الخطوات هي أداة مستقلة بذاتها، وقد تتعطل أي منها بمفردها.
وأحياناً تتضارب نتائج هذه المراحل مع بعضها. فقد تكون الكلمات صحيحة تماماً بينما اسم المتحدث خاطئ. وقد يبدو الملخص مرتباً في حين أن اسم العائلة داخل النص مشوّه. نحن نفضّل أن نعرض المصدر الصوتي مرتبطاً بوقته ونترك الحكم للمراجع البشري، بدلاً من الاكتفاء بوضع نسبة ثقة مئوية فوق النص.
5. ما نفحصه قبل الوثوق بسير عمل
جرّب النظام على أصعب التسجيلات لديك: مكالمة فيديو يتحدث فيها ثلاثة أشخاص في وقت واحد، أو محاضرة مسجلة من المقعد الأخير، أو رسالة صوتية من ممر مزدحم، أو اسم عائلة يتكرر أربعين مرة. بعد ذلك، احسب الوقت الذي تستغرقه للوصول إلى ملف مصحح وجاهز للإرسال فعلاً، لا الوقت الذي يستغرقه البرنامج لإظهار المسودة الأولى.
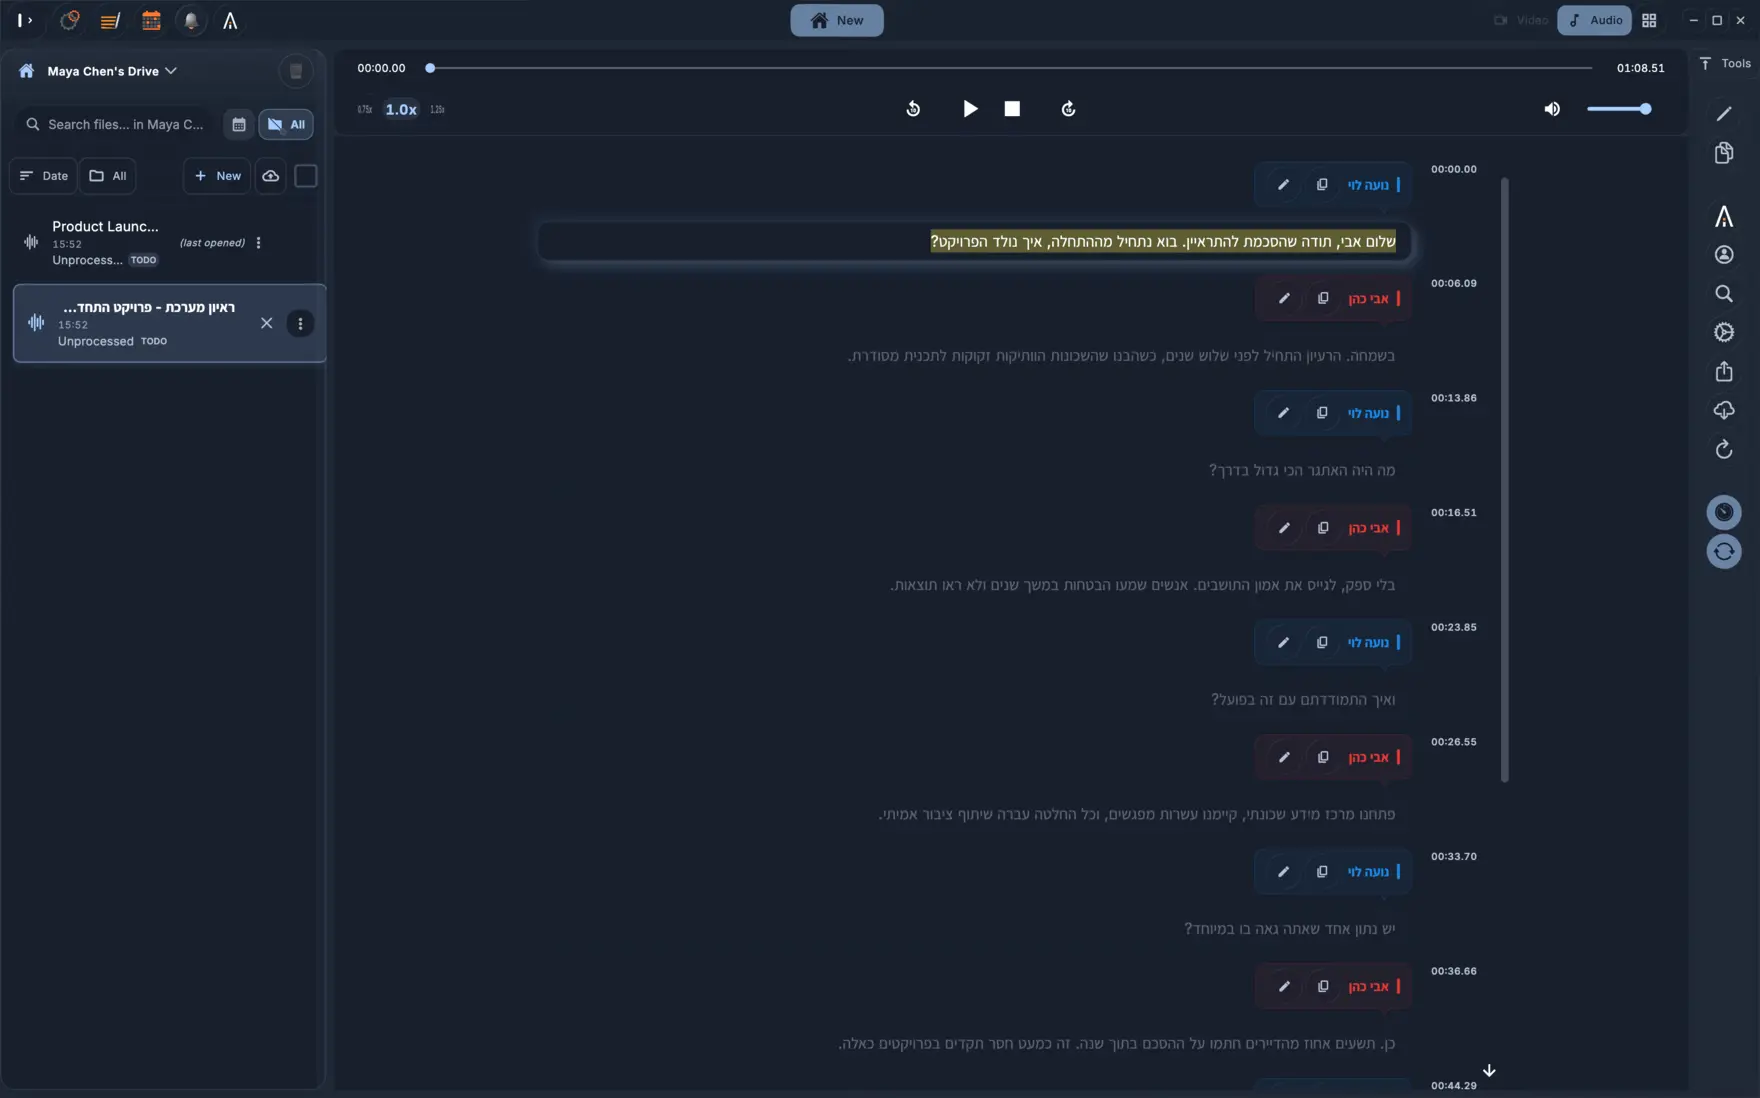
يجمع KolWrite تشغيل الصوت والكلمات والمتحدثين والأختام الزمنية في مساحة عمل واحدة، وينقل هذا التنظيم معه عند تصدير المستندات وملفات الترجمة. هذا لا يلغي احتمالات الخطأ في التعرّف على الكلام، لكنه يجعل المواضع المشكوك فيها سهلة الاكتشاف وسريعة التصحيح. فهذا الجزء من العمل لا يزال يتطلب عيناً بشرية.
أسئلة شائعة
هل التفريغ الآلي هو نفسه التعرّف على الكلام؟
التعرّف على الكلام هو الخطوة التقنية التي تحوّل الصوت إلى كلمات. أما برنامج التفريغ المتكامل فيحيط هذه الخطوة بأدوات أخرى: كشف اللغة، وفصل المتحدثين، وضبط التوقيت، وعلامات الترقيم، والتحرير، والبحث، والتصدير. وأغلب المتاعب اليومية التي يواجهها المستخدم تأتي من هذه الأدوات المحيطة، لا من محرك التعرّف نفسه.
لماذا يبدو النص الخاطئ سليماً في كثير من الأحيان عند قراءته؟
لأن مرحلة فك الترميز تختار تسلسل الكلمات الأرجح بناءً على السياق. وعندما يكون الصوت غير واضح، تتغلب العبارة المنطقية المتوقعة على ما قيل فعلاً، فيخرج النص سلس القراءة رغم خطئه. لذلك احرص دائماً على مراجعة الأسماء والأرقام وأي جملة تنوي اقتباسها بمقارنتها بالتسجيل الصوتي مباشرة.
هل دعم المزيد من اللغات يعني جودة متساوية فيها جميعاً؟
لا. فعدد ساعات التدريب، وتغطية اللهجات المختلفة، ودقة التقييم تتفاوت بشدة من لغة إلى أخرى. قائمة اللغات المدعومة تعني أن النظام قادر على التعامل معها، لكنها ليست ضماناً للدقة في لغتك.
هل تأتي الأختام الزمنية من نفس النموذج الذي ينتج الكلمات؟
ليس دائماً. ففي كثير من الأحيان، تُنتج الأختام الزمنية وأسماء المتحدثين وعلامات الترقيم في مراحل منفصلة. ولهذا السبب قد تجد في النص كلمات صحيحة ولكن في توقيت خاطئ. نحن نتحقق من كل عنصر من هذه العناصر على حدة.
المصادر وقراءات إضافية
- 1Radford et al., Robust Speech Recognition via Large-Scale Weak Supervision
- 2Pratap et al., Scaling Speech Technology to 1,000+ Languages
- 3Zhang et al., Google USM: Scaling Automatic Speech Recognition Beyond 100 Languages
- 4Chi & Bell, Improving Code-switched ASR with Linguistic Information
- 5Turetzky et al., HebDB: a Weakly Supervised Dataset for Hebrew Speech Processing
- 6Hamed et al., Dialectal Arabic-English Code-Switching Speech Recognition