בקיצור
- זיהוי דיבור מנבא מה הטקסט הסביר ביותר עבור קטע אודיו נתון. אין בתוך ההקלטה תסריט מוחבא שהמערכת רק צריכה לשלוף.
- אימון על מאגרי ענק של אודיו רב־לשוני הפך את המודלים ליציבים יותר, אבל תמיכה בשפה מסוימת עדיין לא מבטיחה איכות טובה בה.
- זיהוי דוברים, חותמות זמן, פיסוק וייצוא הם רכיבים נפרדים שיושבים סביב מנוע הזיהוי, וכל אחד מהם יכול להיכשל בפני עצמו.
- המיקרופון והאקוסטיקה בחדר משפיעים בדרך כלל הרבה יותר מהמודל שתבחרו.
- אנחנו משאירים את האודיו, הטקסט המתוזמן והתיקון האנושי במקום אחד, כי שם הטעויות צצות.
1. התוכנה מקבלת אות אודיו, לא משפטים
מבחינת התוכנה, הקלטה היא בסך הכול רשימה ארוכה של מספרים, שכל אחד מהם מייצג את לחץ האוויר ברגע נתון. עוד לפני שמנסים לנחש מילה אחת, חותכים את האודיו לחלונות זמן קצרים ובודקים איך האנרגיה בכל חלון מתפזרת בין התדרים השונים. עם חוקי הפיזיקה אי אפשר להתווכח: שני אנשים שמדברים יחד, הד מהקירות, מאוורר של לפטופ וכיווץ של קובץ מתערבבים כולם לאותו אות בדיוק.
בגלל זה למיקרופון יש משקל גדול יותר ממה שרוב הקונים מצפים. מיקרופון שקרוב לפה תופס היטב את העיצורים ואת הרווחים הקטנים שבין המילים. לעומת זאת, טלפון שמונח במרכז שולחן ישיבות קולט את ההד בחדר ואת כל הדוברים בבת אחת. שום מודל שפה לא ידע לשחזר עיצור שנבלע בחדר.
2. המקודד ממפה את הדיבור
תפקיד המקודד הוא לתרגם מקטעי אודיו קצרים לווקטורים. הווקטורים האלה שומרים את המידע שעוזר לחזות מילים: ניואנסים פונטיים, קצב דיבור, והפרדה חלקית בין קול אנושי, רעש רקע ושקט. מה שהקפיץ את השלב הזה קדימה הוא אימון מקדים בקנה מידה עצום. מאמר מ־2022 תיאר אימון על 680 אלף שעות של אודיו רב־לשוני בפיקוח חלש. מחקרים מאוחרים יותר כבר חצו את רף מאה השפות ובהמשך הגיעו ליותר מאלף, בעיקר בזכות שימוש בהקלטות שאף אחד לא תמלל מראש.123
הכמות הזו נותנת למודל היכרות רחבה, אבל לא איכות שווה. מודל שנחשף ליותר מיקרופונים, מבטאים ונושאי שיחה יופתע פחות מההקלטות שלכם. ועדיין, רשימת שפות נתמכות לא מספרת לכם איך המערכת תתמודד עם שיחת מכירה בעברית, עם ריאיון בערבית פלסטינית, או עם משפט שמתחיל בשפה אחת ומסתיים באחרת.
3. שלב הפענוח: איזה משפט נשמע הגיוני יותר
מנוע הזיהוי לא מפענח מילה־מילה בנפרד. הוא נותן ציון לרצפים שלמים של מילים, גם מול האודיו עצמו וגם מול מה שהוא כבר יודע על מבנה של משפטים. ככה הוא יודע להעדיף ביטוי הגיוני על פני אוסף של צלילים דומים. מהצד השני, בדיוק בגלל זה הוא עלול להמציא משפט רהוט לגמרי שאף אחד לא אמר, ברגע שהאודיו קצת עמום.
החולשה הזו בולטת במיוחד בשמות, במספרים ובמעבר בין שפות. מחקרים על זיהוי דיבור מעורב מצביעים שוב ושוב על אותה בעיה: יש המון הקלטות בכל שפה בנפרד, אבל מעט מאוד הקלטות שבהן הדובר מחליף שפה באמצע משפט. בעברית ובערבית נוספים לזה גם כתיב לא אחיד ומחסור בהקלטות של דיבור ספונטני. מאגרי מחקר חדשים אומנם מגדילים את ההיצע, אבל עדיין לא סוגרים את הפער.456
4. איך שרשרת שלבים מרכיבה תמלול מוגמר במקום תשובה בודדת
מנוע הזיהוי מוציא מילים וזמנים. הפרדת דוברים עונה על שאלה אחרת לגמרי, מי דיבר ומתי. שלב היישור מצמיד כל מילה חזרה לשעון, ופיסוק וחלוקה לפסקאות הופכים את הטקסט לקריא. אחריהם מגיעים האחסון, הניסיונות החוזרים, העריכה, החיפוש והייצוא. כל שלב כזה הוא רכיב נפרד, וכל אחד מהם יכול להיכשל לבדו.
לפעמים השלבים האלה גם מתנגשים אחד בשני. המילים עצמן יכולות להיות מדויקות לגמרי, בזמן ששיוך הדובר שגוי. סיכום פגישה יכול להיראות מסודר ונקי, אפילו ששם משפחה בתוך התמלול התעוות לחלוטין. לכן אנחנו מעדיפים להציג את המקור המתוזמן ולתת לעין אנושית להחליט, במקום פשוט להדביק מעל הטקסט ציון ביטחון.
5. מה אנחנו בודקים לפני שסומכים על תהליך עבודה
כשאתם בוחנים מערכת, נסו אותה על החומרים הכי קשים שלכם: שיחת וידאו שבה שלושה אנשים מדברים אחד על השני, הרצאה שהוקלטה מהשורה האחרונה באולם, הודעה קולית ממסדרון רועש, או שם משפחה שחוזר ארבעים פעם. אחרי שהרצתם את הקובץ, תמדדו כמה זמן לוקח לכם להגיע למסמך מתוקן שבאמת הייתם שולחים הלאה, ולא כמה מהר מופיע הטקסט הראשוני על המסך.
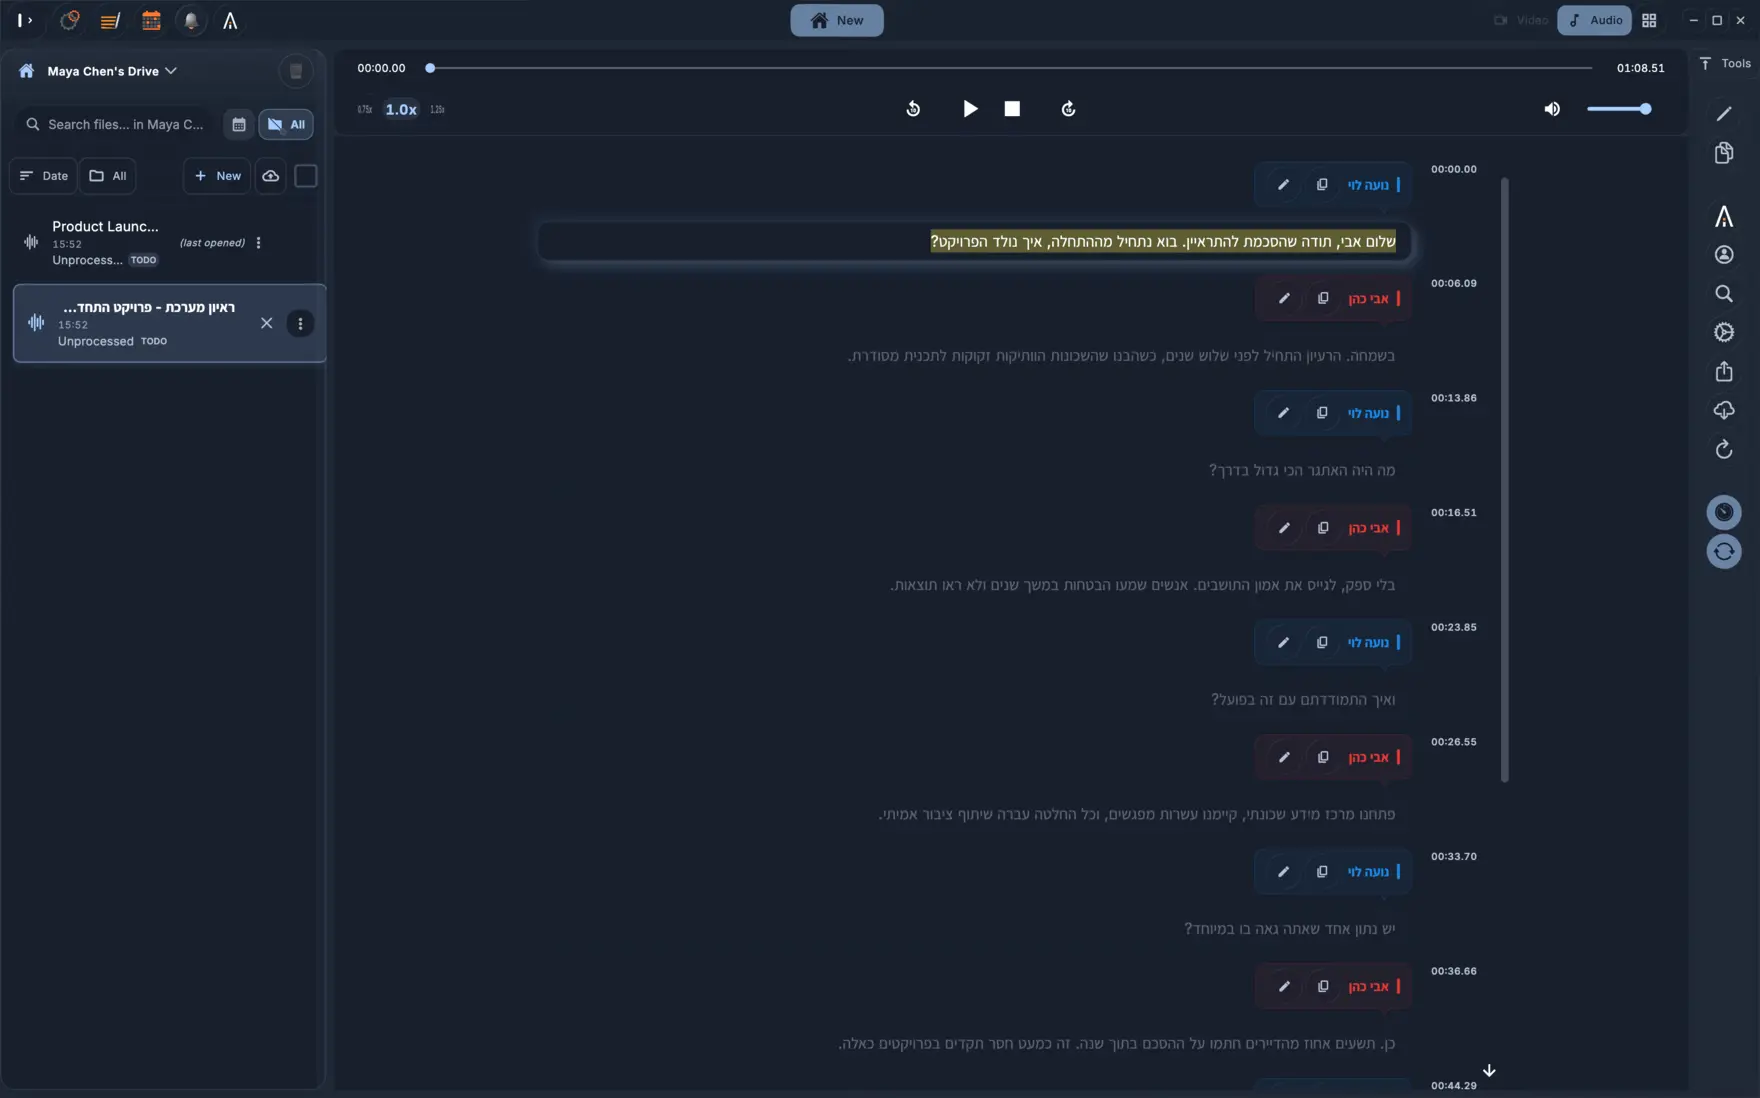
KolWrite מרכזת את השמעת האודיו, המילים, הדוברים וחותמות הזמן בסביבת עבודה אחת, ושומרת על המבנה הזה גם כשמייצאים למסמכים ולקובצי כתוביות. זה לא מעלים את חוסר הוודאות המובנה בזיהוי דיבור, אבל זה מאפשר למצוא את המקומות הבעייתיים בקלות ולתקן אותם מהר. החלק הזה של העבודה עדיין דורש בן אדם.
שאלות שחוזרות
האם תמלול AI וזיהוי דיבור זה אותו דבר?
זיהוי דיבור הוא רק השלב שהופך אודיו למילים. מוצר תמלול שלם עוטף אותו בזיהוי שפה, הפרדת דוברים, תזמון, פיסוק, עריכה, חיפוש וייצוא. ביומיום, רוב התסכול מגיע מהמעטפת הזו ולא ממנוע הזיהוי עצמו.
למה תמלול עם טעויות נקרא הרבה פעמים כל כך חלק?
כי המפענח בוחר רצף מילים שנשמע סביר לפי ההקשר. כשהאודיו לא ברור, ניסוח הגיוני גובר על מה שנאמר בפועל, והמשפט שמתקבל נקרא שוטף לגמרי. לכן כדאי תמיד לחזור להקלטה ולבדוק שמות, מספרים וכל משפט שאתם מתכוונים לצטט.
אם מערכת תומכת בהרבה שפות, זה אומר שהאיכות בהן זהה?
ממש לא. כמות שעות האימון, הכיסוי של להגים שונים ואיכות הבדיקות משתנים מאוד משפה לשפה. רשימת שפות מראה שהיכולת קיימת טכנית, אבל היא לא אומרת כלום על רמת הדיוק בשפה שלכם.
האם חותמות הזמן מגיעות מאותו מודל שמזהה את המילים?
לא תמיד. תזמון, שיוך דוברים ופיסוק מופקים הרבה פעמים בשלבים נפרדים. ככה קורה שתמלול מכיל את המילים הנכונות, אבל ברגע הלא נכון. אנחנו בודקים כל אחד מהרכיבים האלה בנפרד.
מקורות וקריאה נוספת
- 1Radford et al., Robust Speech Recognition via Large-Scale Weak Supervision
- 2Pratap et al., Scaling Speech Technology to 1,000+ Languages
- 3Zhang et al., Google USM: Scaling Automatic Speech Recognition Beyond 100 Languages
- 4Chi & Bell, Improving Code-switched ASR with Linguistic Information
- 5Turetzky et al., HebDB: a Weakly Supervised Dataset for Hebrew Speech Processing
- 6Hamed et al., Dialectal Arabic-English Code-Switching Speech Recognition