בקיצור
- שיעור שגיאות המילים משווה את הפלט לתמלול שכתב אדם, וסופר החלפות, השמטות ותוספות.
- תשנו את כללי הנרמול, את הכתיב או את קובצי הבדיקה, ואותה מערכת בדיוק תקבל ציון אחר.
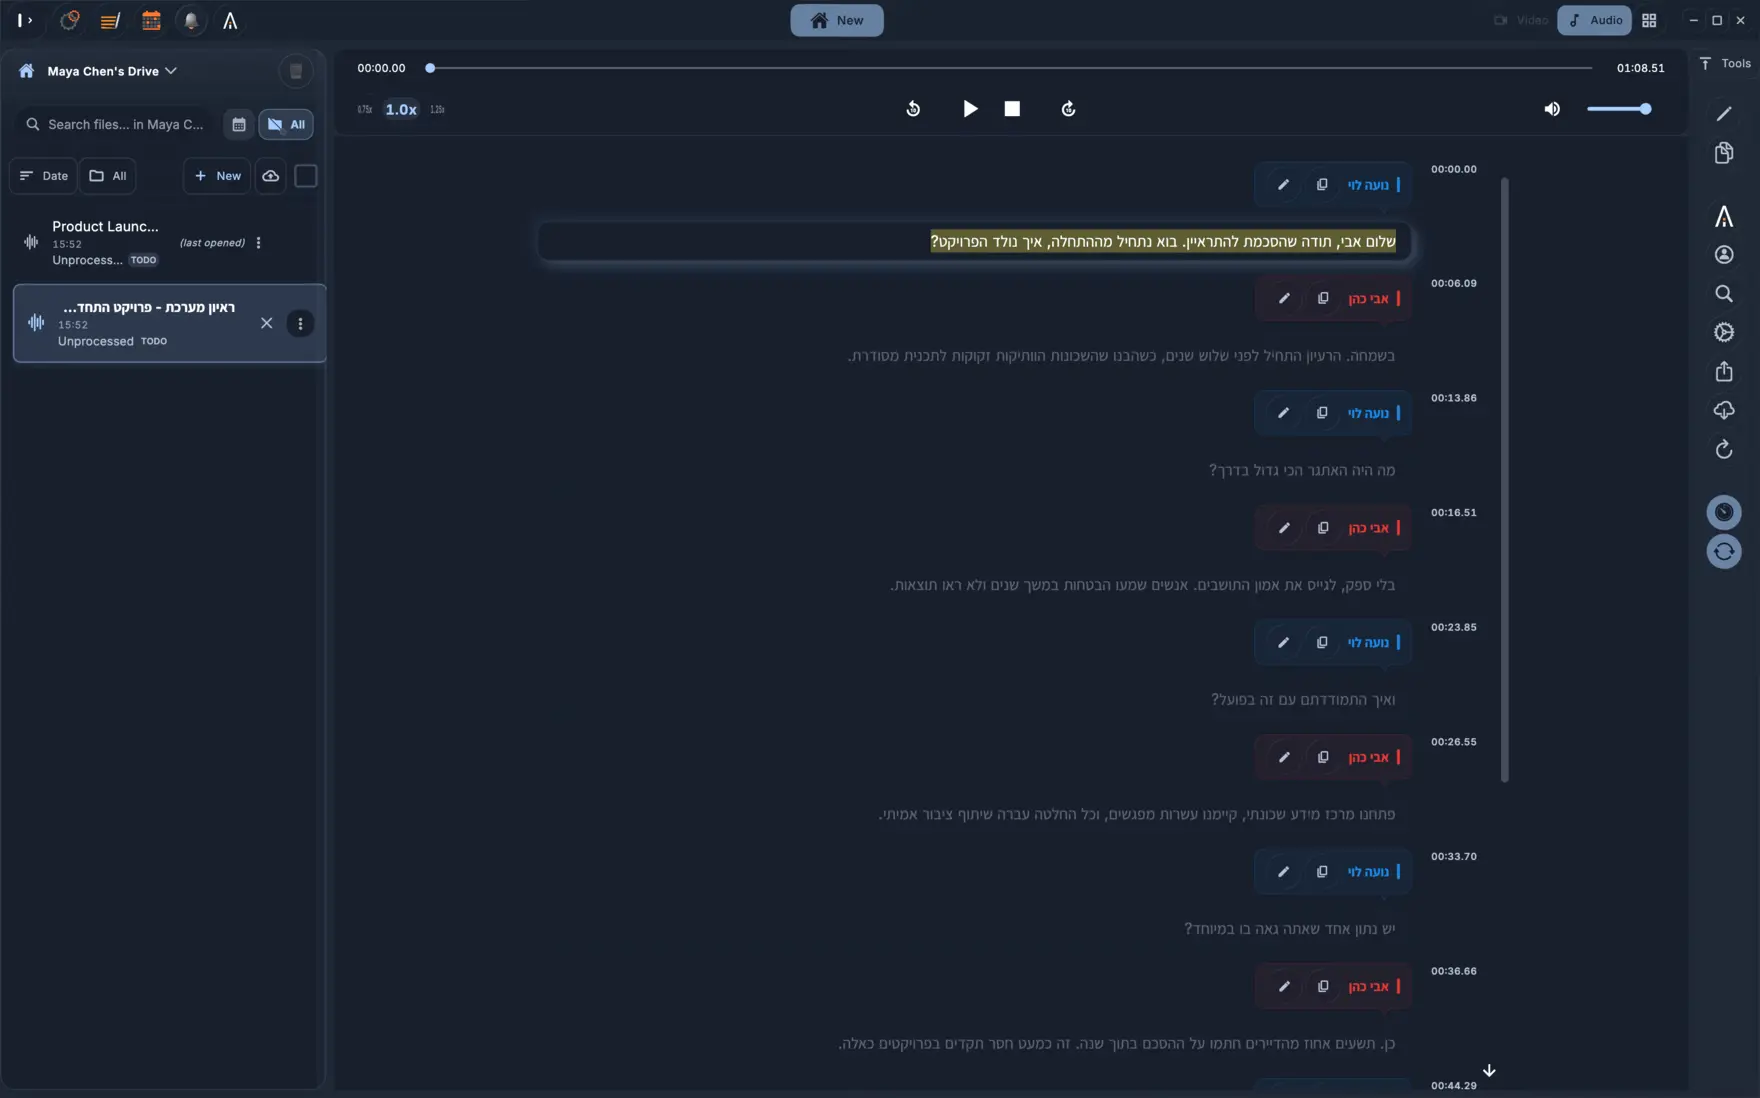
- שיוך דוברים, חותמות זמן, קטעים שנעלמו, שמות ואיכות הייצוא דורשים כל אחד בדיקה משלו.
- הבדיקה שתעזור לכם באמת היא סט קבוע מההקלטות שלכם, שמריצים ובודקים כל פעם באותה צורה.
- ב־KolWrite לא מפרסמים נתון דיוק יחיד, כי מספר כזה ממילא לא יעמוד במבחן של האודיו שלכם.
1. מה שיעור שגיאות המילים סופר
שיעור שגיאות המילים (שבדרך כלל מקצרים ל־WER) מעמיד את פלט המכונה מול תמלול ייחוס שכתב אדם, וסופר שלוש טעויות: מילה שגויה, מילה שחסרה ומילה שנוספה. את הסכום מחלקים במספר המילים בתמלול האנושי. תוכניות ההערכה של NIST מצרפות כלי ניקוד אחידים משלהן, כי אפילו מדד כזה פשוט תלוי באיך מכינים את שני הטקסטים ואיך מתאימים ביניהם.1
בבדיקת מעבדה יש למדד הזה הרבה ערך. אותו אודיו, אותו תמלול ייחוס, אותם חוקים לשני הצדדים. אבל הוא מאבד משמעות כשמערכת אחת מוחקת מילות מילוי והשנייה משאירה אותן, או כשתמלול אחד משאיר שם לועזי באותיות לטיניות והשני מתעתק אותו. המספר לא משקר, הוא פשוט עונה על שאלה אחרת.
2. קובצי הבדיקה משפיעים על הציון יותר מהמודל
טקסט שמוקרא לתוך מיקרופון טוב לא דומה לשיחת שירות, להרצאה באולם או לארבעה אנשים שמדברים סביב לפטופ. מחקר מ־2022 על אימון בפיקוח חלש פרסם את התוצאות שלו בנפרד לכל מאגר ולכל שפה, בלי מספר אחד בכותרת. ככה מדווחים בצורה הוגנת.2
בעברית ובערבית, השוואה חפיפניקית מתפרקת אפילו מהר יותר. כללי הכתיב קובעים מה בכלל נחשב למילה אחת. הלהג, המעבר בין שפות וכמות הדיבור הספונטני בהקלטה משנים לגמרי את רמת הקושי. ב־2024 פורסם מאגר בעברית שנבנה בין היתר כדי להוסיף דיבור טבעי ולא מתוסרט למאגר הדל הקיים, ובמחקרים על ערבית מתייחסים לדיבור בלהג מקומי ובשפות מעורבות כאל בעיה נפרדת.345
3. מה ציון אחד מסתיר
הציון הזה לא יגיד לכם אם המילים הנכונות שויכו לדובר הנכון. הוא גם לא יספר לכם שחותמות הזמן בורחות, שדקה שלמה נעלמה אחרי ניסיון חוזר שנכשל, או ששורת הכתובית ארוכה מדי ואי אפשר להספיק לקרוא אותה לפני שהיא נעלמת מהמסך. מבחינתו, מילית שנשמטה וטעות במינון של תרופה עולות בדיוק אותו דבר.
במקום מספר אחד, אנחנו בודקים שישה דברים: אודיו שנעלם, מילים, שיוך דוברים, שמות ומספרים, תזמון, וכמה דקות לוקח לבן אדם לתקן את התוצאה. אם התוצר הסופי הוא מסמך או קובץ כתוביות, אנחנו מוסיפים גם את הדיוק בייצוא. במקום לדבר על דיוק באוויר, יש כאן בדיקה שכל אחד יכול לחזור עליה.
4. בדיקה שגם צוות קטן יכול להריץ כמו שצריך
קחו סט קבוע של הקלטות שנראות כמו העבודה היומיומית שלכם: נקיות ורועשות, קצרות וארוכות, עם דובר אחד ועם חמישה, ועם שילובי השפות שאנשים אצלכם באמת מדברים. שמרו בצד את הקבצים המקוריים, את תמלול הייחוס האנושי, את ההגדרות ואת התאריך של כל הרצה. אם מרעננים את הסט בשקט ומכניסים קבצים קלים יותר, הבדיקה מפסיקה למדוד.
איפה שאפשר, הסתירו מהבודק איזה כלי יצר את התמלול. ספרו את הטעויות לפני שמישהו עובר ומסדר את הטקסט, ורשמו את ציון המכונה ליד דקות העבודה האנושית. אחרי כל שינוי במודל או בתהליך העיבוד, הריצו את הבדיקה מחדש. אל תוציאו מהסט את הקבצים הקשים, גם כשהתוצאות עליהם מביכות.
5. מה כוללת טענת דיוק הוגנת
נתון שאפשר באמת לעבוד איתו מפרט את השפה, התחום, המאגר, תנאי ההקלטה, שיטת המדידה, כללי הנרמול, מספר הקבצים, גרסת המוצר והתאריך. הוא גם מציין מה לא נבדק. בלי הפירוט הזה, אחוז הדיוק הוא סתם סיסמה.
לא פרסמנו מספר דיוק ל־KolWrite, וגם לא נמציא מספר כזה לכבוד העמוד הזה. ההשוואה שאנחנו מציעים הרבה יותר אפורה, והרבה יותר מועילה: קחו את אותן הקלטות קשות והעבירו אותן בכל הכלים, בדקו את השמות והדוברים מול השמע, ייצאו את הקובץ הסופי שאתם באמת צריכים לשלוח, ותראו כמה עבודת תיקון נשארה לכם.
שאלות שחוזרות
מה זה אומר 99% דיוק?
בפני עצמו, כמעט כלום. זה יכול להיות שגיאה אחת למאה מילים בתמלול הייחוס, תחת כללי נרמול ספציפיים ועל קבצים שהמוכר בחר בעצמו. תשאלו אילו הקלטות נבדקו, באיזה מדד, לפי אילו כללים ובאיזה תאריך. אם אין תשובות, התייחסו לזה כאל פרסומת.
שני כלים יכולים לקבל ציון שונה על אותו אודיו?
כן, בקלות. תמלולי ייחוס שונים, או טיפול שונה בפיסוק, במספרים, במילות מילוי ובכתיב, ישנו את התוצאה. בהשוואה הוגנת סוגרים את כל ההחלטות האלה לפני שמתחילים לנקד.
מה עוד כדאי למדוד חוץ משיעור שגיאות המילים?
קטעים שנעלמו, שיוך דוברים, שמות ומספרים, תזמון של מילים או מקטעים, חלוקת שורות בכתוביות, דיוק בייצוא, באיזו תדירות עבודה נכשלת, וכמה זמן לוקח לאדם להביא את הקובץ למצב מוגמר.
אפשר לבחור כלי תמלול לפי מבחן השוואה ציבורי?
זו נקודת התחלה. במאגרים ציבוריים כמעט אף פעם אין את החדרים שלכם, המבטאים שלכם או אוצר המילים שלכם. אנחנו מעדיפים לראות עשר הקלטות משלכם שנבדקו בצורה אחידה מאשר טבלת דירוג שנבנתה על אודיו של מישהו אחר.
מקורות וקריאה נוספת
- 1NIST, Open Speech Analytic Technologies Pilot Evaluation Plan
- 2Radford et al., Robust Speech Recognition via Large-Scale Weak Supervision
- 3Turetzky et al., HebDB: a Weakly Supervised Dataset for Hebrew Speech Processing
- 4Hamed et al., Dialectal Arabic-English Code-Switching Speech Recognition
- 5Chi & Bell, Improving Code-switched ASR with Linguistic Information