الخلاصة السريعة
- يحسب معدل خطأ الكلمات ما استُبدل أو حُذف أو أُضيف من كلمات مقارنةً بنص مرجعي كتبه إنسان.
- تغيير قواعد توحيد النص أو الإملاء أو ملفات الاختبار يكفي ليحصل النظام نفسه على نتيجة مختلفة.
- نسب الكلام للمتحدثين، والأختام الزمنية، والمقاطع الساقطة، والأسماء، وجودة التصدير كلها عناصر تحتاج إلى فحص مستقل.
- الاختبار الذي ينفعك فعلاً هو مجموعة ثابتة من تسجيلاتك أنت، تقيسها بالطريقة نفسها في كل مرة.
- لا ننشر رقم دقة واحداً لـ KolWrite، لأن أي رقم منفرد لن يصمد أمام تسجيلاتك الفعلية.
1. ما الذي يحسبه معدل خطأ الكلمات
يقارن معدل خطأ الكلمات (ويُختصر عادةً إلى WER) النص الذي أخرجته الآلة بنص مرجعي كتبه إنسان، ويحصي ثلاثة أخطاء: كلمة خطأ، أو كلمة ناقصة، أو كلمة زائدة. بعد ذلك يُقسم مجموع هذه الأخطاء على إجمالي كلمات النص المرجعي. وتوزع برامج التقييم في NIST أدوات قياس موحدة مع خططها، لأن هذا المقياس البسيط نفسه يتأثر بطريقة تجهيز النصين ومطابقتهما.1
يؤدي هذا المقياس غرضه داخل تجربة مضبوطة تستخدم نفس الصوت ونفس المرجع ونفس القواعد على الطرفين. لكنه يفقد قيمته إذا كان أحد الأنظمة يحذف كلمات الحشو بينما يبقيها نظام آخر، أو إذا كتب مرجع اسماً أجنبياً بحروف لاتينية ونقله مرجع آخر صوتياً. الرقم هنا لا يكذب، لكنه يجيب عن سؤال مختلف.
2. ملفات الاختبار تغيّر النتيجة أكثر من النموذج
قراءة نص مكتوب أمام ميكروفون جيد لا تغني عن مكالمة دعم، أو قاعة محاضرات، أو أربعة أشخاص حول حاسوب محمول. وفي بحث نُشر عام 2022 عن التدريب بإشراف ضعيف، عُرضت النتائج لكل مجموعة بيانات ولكل لغة على حدة، بدلاً من رقم واحد في العنوان. هذه هي الطريقة الأمينة في نشر النتائج.2
وتنهار المقارنات المتسرعة على نحو أسرع في العربية والعبرية؛ فرسم الإملاء يحدد ما يُعدّ كلمة واحدة. كما أن اللهجات، والتنقل بين اللغات، ونسبة الكلام العفوي تغيّر مستوى صعوبة الملف. وقد صُممت مجموعة بيانات عبرية صدرت عام 2024 جزئياً لإضافة كلام طبيعي غير مكتوب مسبقاً إلى رصيد شحيح، فيما تتعامل الأبحاث العربية مع الكلام باللهجات والمختلط بلغات أخرى بوصفه مسألة مستقلة.345
3. ما الذي يخفيه الرقم الواحد
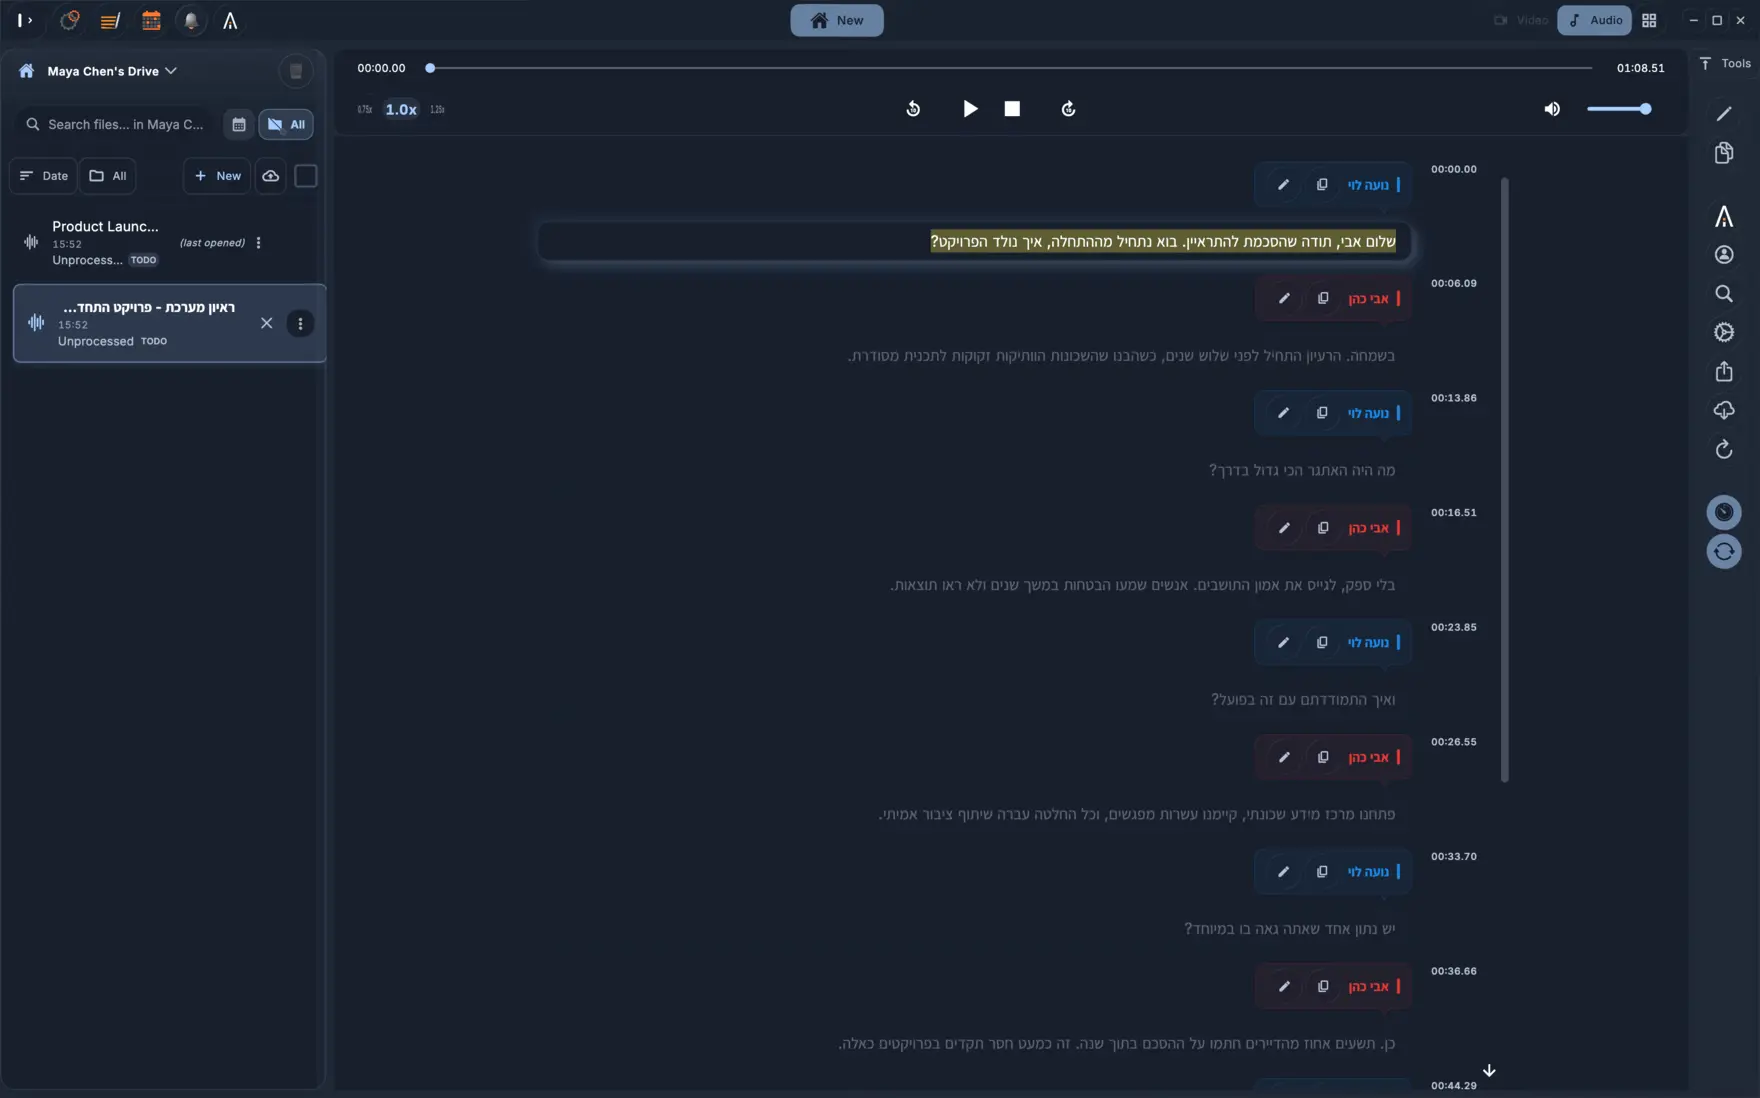
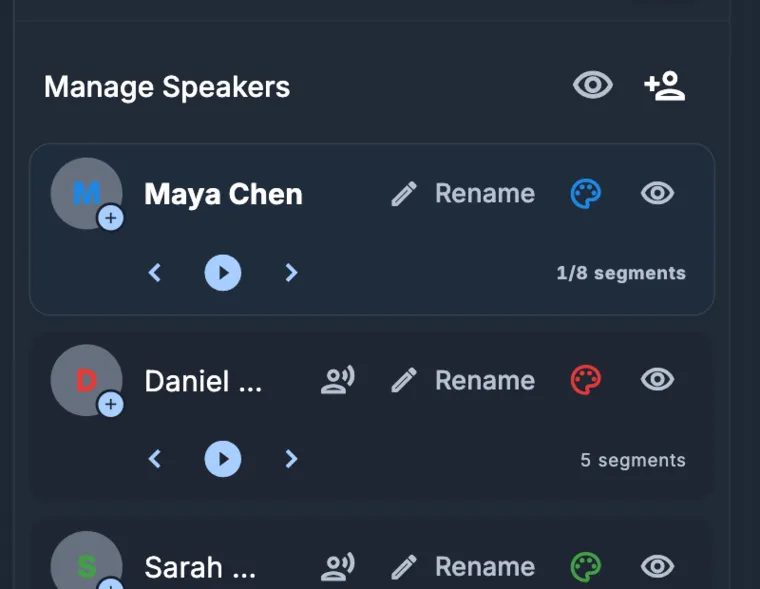
لا يخبرك هذا الرقم إن كانت الكلمات الصحيحة قد نُسبت إلى المتحدث الصحيح. ولا يكشف انحراف التوقيت، أو اختفاء دقيقة كاملة بعد فشل إعادة المحاولة، أو سطر تعليق طويل يختفي عن الشاشة قبل أن يكمل المشاهد قراءته. وهو يحسب الخطأ نفسه عند سقوط أداة تعريف وعند تبديل جرعة دواء.
نحن نتابع ستة عناصر بدلاً من عنصر واحد: الصوت الناقص، والكلمات، ونسب الكلام للمتحدثين، والأسماء والأرقام، والتوقيت، والدقائق التي يقضيها شخص في تصحيح النتيجة. وحين يكون المخرج النهائي مستنداً أو ملف تعليقات، نضيف إليه أمانة التصدير. بهذا تتحول الدقة من مجرد صفة إلى فحص يمكن لأي شخص تكراره.
4. اختبار نزيه يمكن لفريق صغير تطبيقه
ثبّت مجموعة تسجيلات تشبه عملك الفعلي: ملفات نقية وأخرى صاخبة، قصيرة وطويلة، بمتحدث واحد وبخمسة متحدثين، وبمزيج اللغات الذي يتحدث به فريقك فعلاً. احتفظ بالملفات الأصلية والنص المرجعي البشري والإعدادات وتاريخ كل تجربة. أما المجموعة التي تُستبدل ملفاتها الصعبة بأخرى أسهل في الخفاء، فلم تعد تقيس شيئاً.
أخفِ اسم الأداة عن المراجع متى استطعت، واحسب الأخطاء قبل أن ينقّح أحد النص. سجّل نتيجة الآلة وبجانبها الدقائق التي استغرقها الإنسان. ثم أعد الاختبار بعد أي تعديل في النموذج أو مسار المعالجة، وأبقِ الملفات الصعبة ضمن المجموعة حتى لو كانت نتائجها محرجة.
5. ملامح الادعاء الصادق حول الدقة
الادعاء الذي يمكنك الاعتماد عليه يحدد اللغة، والمجال، ومجموعة البيانات، وظروف التسجيل، والمقياس المستخدم، وقواعد توحيد النص، وعدد الملفات، وإصدار المنتج، والتاريخ. ويوضح أيضاً ما لم يشمله القياس. من دون هذه التفاصيل تظل النسبة المئوية مجرد شعار إعلاني.
لم ننشر رقم دقة لـ KolWrite، ولن نختلق رقماً لنضعه في صفحة كهذه. المقارنة التي نقترحها أقل بريقاً ولكنها أكثر نفعاً: مرّر التسجيلات الصعبة نفسها عبر كل أداة، وراجع الأسماء والمتحدثين مع الاستماع للصوت، وصدّر الملف بالصيغة التي سترسلها فعلاً، ثم احسب كم بقي عليك من العمل.
أسئلة شائعة
ماذا تعني عبارة دقة 99%؟
بمفردها، لا تعني شيئاً تقريباً. قد تعني خطأً واحداً في كل مئة كلمة مرجعية وفق قواعد توحيد محددة، وعلى ملفات اختارها البائع نفسه. اسأل عن التسجيلات والمقياس والقواعد وتاريخ الاختبار. إن غابت هذه الإجابات، فتعامل مع الرقم على أنه دعاية.
هل يمكن أن تحصل أداتان على نتيجتين مختلفتين لنفس الملف الصوتي؟
نعم، وبكل سهولة. فاختلاف النص المرجعي، وطريقة التعامل مع علامات الترقيم والأرقام وكلمات الحشو والإملاء، كلها عوامل تغيّر النتيجة. المقارنة العادلة تثبّت هذه القواعد قبل أن يبدأ أي تقييم.
ماذا يجب أن نقيس إلى جانب معدل خطأ الكلمات؟
المقاطع الساقطة، ونسب الكلام للمتحدثين، والأسماء والأرقام، وتوقيت الكلمات أو المقاطع، وتنسيق التعليقات، وأمانة التصدير، ومعدل فشل المهام، والوقت البشري اللازم للوصول إلى ملف نهائي جاهز.
هل يكفي مؤشر قياس عام لاختيار أداة تفريغ؟
يصلح نقطة بداية. فمجموعات البيانات العامة نادراً ما تضم غرفك أو لهجاتك أو مفرداتك. ونحن نفضل رؤية عشرة تسجيلات من عندك تُقيَّم بطريقة موحدة، على جدول ترتيب مبني على صوت غيرك.
المصادر وقراءات إضافية
- 1NIST, Open Speech Analytic Technologies Pilot Evaluation Plan
- 2Radford et al., Robust Speech Recognition via Large-Scale Weak Supervision
- 3Turetzky et al., HebDB: a Weakly Supervised Dataset for Hebrew Speech Processing
- 4Hamed et al., Dialectal Arabic-English Code-Switching Speech Recognition
- 5Chi & Bell, Improving Code-switched ASR with Linguistic Information